Volle Enumeration statt Top-k: Map-Reduce im Research-Modus
AnwenderDer normale Chat und der Research-Modus durchsuchen dieselbe Wissensdatenbank — aber auf grundlegend verschiedene Weise. Dieser Artikel erklärt den Unterschied und warum er für bestimmte Fragen entscheidend ist.
Das Problem mit Top-k
Section titled “Das Problem mit Top-k”Bei einer normalen Frage sucht CompanyWizard die relevantesten Stellen heraus und reicht diese Handvoll als Kontext an das Modell (RAG). Wie viele Stellen das sind, ist begrenzt — das k in „Top-k”. → RAG & Suche
Für die meisten Fragen ist das genau richtig: Sie wollen eine Antwort, keine Volltextrecherche, und die passendsten Dokumente enthalten sie.
Für aufzählende und aggregierende Fragen bricht das Prinzip aber zusammen. Fragen Sie „Welche Kunden haben einen ADV?”, dann ist die richtige Antwort die vollständige Liste. Top-k liefert Ihnen die Kunden aus den relevantesten Dokumenten — und schweigt über alle übrigen. Das Ergebnis sieht vollständig aus, ist es aber nicht. Genauso bei „In wie vielen Projekten kommt Technologie X vor?”: Gezählt würde nur, was im Ausschnitt lag.
Das Problem ist nicht, dass die Suche schlecht wäre. Sie ist für eine andere Aufgabe gebaut.
Die Antwort: jedes Dokument einmal ansehen
Section titled “Die Antwort: jedes Dokument einmal ansehen”Der Research-Modus dreht das Vorgehen um. Statt zu fragen „welche Dokumente passen am besten?” sichtet er alle, die der Fragende sehen darf. Der Lauf läuft dabei in fünf Phasen ab, die Sie während der Recherche auch am Composer-Schalter ablesen können:
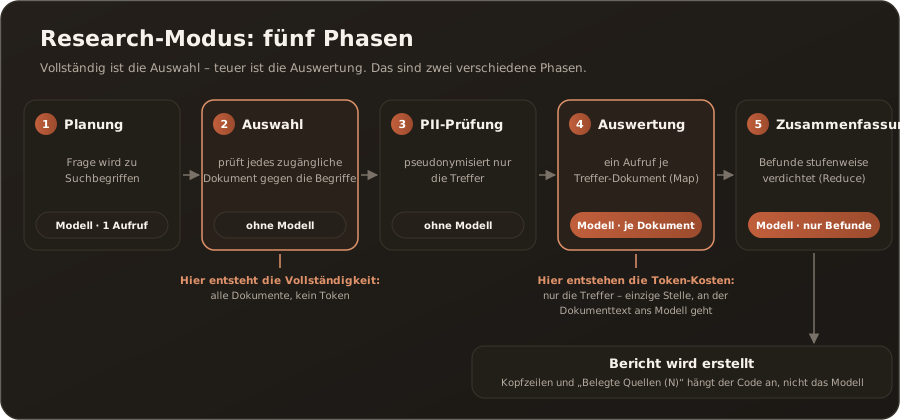
1. Planung. Ein einzelner Modell-Aufruf übersetzt Ihre Frage in konkrete Suchbegriffe. Das ist der einzige Aufruf, bevor überhaupt ein Dokument angefasst wird.
2. Auswahl — vollständig, aber ohne Modell. Jetzt geht der Lauf jedes zugängliche Dokument durch und prüft es gegen die geplanten Begriffe. Entscheidend: Diese Sichtung passiert rein lokal. Kein Dokument verlässt dabei den Prozess, kein Modell wird gefragt. Genau hier entsteht die Vollständigkeit — nichts wird übersprungen, weil es in einer Ähnlichkeitsrangliste zu weit unten stand.
3. PII-Prüfung — nur der Auswahl. Die Textstellen, die die Auswahl behalten hat, werden pseudonymisiert. Nur sie, denn nur sie werden gleich das Modell sehen.
4. Auswertung (Map) — ein Aufruf je Dokument. Die ausgewählten Textstellen gehen je Dokument gebündelt an das Modell: „Was steht hier zu meiner Frage?” Alle Treffer-Stellen eines Dokuments landen in einem Aufruf, mehrere Dokumente werden parallel ausgewertet. Die Quellangabe hängt der Code an jeden Befund, nicht das Modell — damit bleibt der Bericht verlinkbar, ohne dass es auf die Sorgfalt des Modells ankommt.
5. Zusammenfassung (Reduce) — stufenweise. Die vielen kleinen Auswertungen werden hierarchisch zusammengezogen: erst Gruppen zu Zwischenergebnissen, diese wieder zu größeren, bis am Ende ein zusammenhängender Bericht steht. Diese Hierarchie ist nötig, weil die Summe aller Einzelbefunde sonst nicht in einen einzigen Modell-Aufruf passen würde.
Das Ergebnis ist ein Markdown-Bericht, der auf einer vollständigen Sichtung beruht statt auf einem Ausschnitt. Während er zusammengesetzt und zugestellt wird, zeigt der Composer-Schalter kurz Bericht wird erstellt.
Warum der Quellen-Anhang nicht vom Modell stammt
Section titled “Warum der Quellen-Anhang nicht vom Modell stammt”Der Bericht endet mit einer Liste „Belegte Quellen (N)” — ein Eintrag je Dokument, aus dem ein Befund kam. Diese Liste erzeugt der Code, nicht das Sprachmodell, und sie wird erst nach der Zusammenfassung angehängt.
Der Grund liegt in Phase 5. Die Zusammenfassung zieht viele Einzelbefunde zu einem lesbaren Text zusammen, und dabei kann ein Befund unter den Tisch fallen — das Modell entscheidet, was in den Fließtext gehört. Käme die Quellenliste aus derselben Hand, verschwände die Quelle mit dem Befund, und der Bericht sähe vollständig aus, obwohl er es nicht ist. Genau das ist die Fehlerart, die bei einer aufzählenden Frage am teuersten ist.
Deshalb trägt jeder Befund seine Quellangabe schon aus Phase 4 mit, an fester Position, und der Anhang wird daraus zusammengesetzt. Die Zusammenfassung darf kürzen — eine belegte Quelle kann sie nicht mehr verschlucken. Aus demselben Grund steht der Anhang auch dann im Bericht, wenn die Zusammenfassung komplett fehlschlägt.
Auch die Kopfzeile am Berichtsanfang (durchsuchte Dokumente, Treffer, ausgewertete Passagen, Suchbegriffe) kommt aus dem Code, nicht aus dem Modell. Sie beschreibt, was der Lauf getan hat — nicht, was das Modell darüber sagt.
Was das kostet
Section titled “Was das kostet”Vollständigkeit hat einen Preis, und der ist der ehrliche Grund, warum der Modus nicht immer an ist:
- Zeit: Der Lauf braucht Minuten statt Sekunden — meist einige, bei vielen Treffern auch deutlich mehr. Er macht einen Modell-Aufruf je Treffer-Dokument, und die Zusammenfassung kann erst laufen, wenn die Auswertung steht.
- Tokens: Deutlich mehr als eine normale Antwort. Der Verbrauch richtet sich aber nach der Treffermenge zu Ihrer Frage, nicht nach der Größe der Wissensdatenbank: Die Sichtung aller Dokumente ist kostenlos, weil sie ohne Modell auskommt, und ans Modell geht nur, was die Auswahl behalten hat. Eine eng gestellte Frage über eine große Wissensdatenbank kann daher billiger sein als eine weit gestellte über eine kleine.
- Eine zur Zeit: Pro Benutzer läuft immer nur eine aus dem Chat gestartete Recherche — auch eine laufende Web-Recherche blockiert eine zweite. Wer währenddessen den Schalter einschaltet, bekommt eine normale Antwort mit einem Hinweis darauf. → Research-Modus
Deshalb ist der Research-Modus ein bewusst zuschaltbarer Modus pro Frage und kein neuer Standard.
Robust gegen einzelne Ausfälle
Section titled “Robust gegen einzelne Ausfälle”Bei vielen Auswertungs-Aufrufen wird immer mal einer scheitern — ein Timeout, eine unerwartete Antwort des Modells. Der Lauf degradiert in diesem Fall, statt komplett abzubrechen: Das betroffene Dokument fällt aus der Auswertung, der Bericht wird trotzdem erstellt und zugestellt — mit dem Hinweis „N Dokument(e) konnten nicht ausgewertet werden” gleich unter der Kopfzeile. Ein einzelner Fehler kostet Sie also Fundstellen, nicht die ganze Recherche.
Dasselbe gilt für ein Modell, das gar nicht antwortet: Jeder Auswertungs-Aufruf hat eine Frist von 60 Sekunden, jeder Zusammenfassungs-Aufruf eine von 180 Sekunden. Hängt der Anbieter, verliert der Lauf das betroffene Dokument bzw. liefert die Befunde unzusammengefasst aus — statt stumm bis ans Laufzeit-Limit zu warten.
Eine Ausnahme gibt es: Fällt die PII-Prüfung aus, bricht der Lauf ab, statt weiterzumachen — siehe unten.
Berechtigungen und personenbezogene Daten
Section titled “Berechtigungen und personenbezogene Daten”Der Lauf sieht nur, was Sie sehen dürfen. Die Enumeration ist an Ihre Berechtigungen gebunden; Vaults und Dokumente ohne Ihren Zugriff sind für den Lauf nicht vorhanden. → RBAC & Vertraulichkeit
Für personenbezogene Daten gilt dasselbe Prinzip wie im übrigen Chat: An der Grenze zum Sprachmodell stehen nur Pseudonyme, nicht die Klardaten. Der Ablauf oben ist genau darauf gebaut — es gibt eine einzige Stelle, an der Text den Prozess verlässt: die Auswertung. Die Sichtung davor liest zwar Klartext, gibt ihn aber nicht heraus, und die Zusammenfassung danach sieht nur noch Modell-Ausgaben.
Der Bericht bleibt während des gesamten Laufs pseudonymisiert und wird erst am Lauf-Ende in Klardaten zurückübersetzt. Ist der Pseudonymisierungs-Dienst nicht erreichbar, bricht der Lauf ab, statt ungeprüften Klartext an das Modell zu geben (fail-closed). Der Lauf prüft die Verfügbarkeit dafür selbst — vor und nach der Prüfphase — und verlässt sich nicht darauf, dass ein Ausfall als „nichts gefunden” durchgereicht wird. → Der PII-Schild
Wenn Sie den Schild vor dem Start abschalten
Section titled “Wenn Sie den Schild vor dem Start abschalten”Das oben Beschriebene gilt für den Regelfall: Schild an. Schalten Sie den PII-Schild ab und starten dann eine Recherche, läuft der gesamte Lauf unpseudonymisiert — die Textstellen gehen im Klartext an das Modell. Das ist kein Versehen, sondern dasselbe bewusste Opt-out wie im normalen Chat, nur eben für Minuten statt für eine Nachricht.
Zwei Eigenheiten, die man kennen sollte:
- Es zählt die Schild-Stellung beim Start. Die Recherche übernimmt sie aus der Nachricht, die den Lauf auslöst, und behält sie bis zum Ende bei. Schalten Sie den Schild während des Laufs wieder ein, gilt das für den laufenden Bericht nicht mehr.
- Der Schild kostet Sie kaum Ergebnisqualität. Die Auswertung arbeitet mit Pseudonymen genauso zuverlässig wie mit Klarnamen — die Befunde fallen praktisch gleich aus. Den Schild für eine Recherche abzuschalten bringt also wenig und gibt viel preis.
Verwandt
Section titled “Verwandt”- Research-Modus — das Feature aus Benutzersicht
- Eine aufzählende Frage stellen
- RAG & Suche · Der PII-Schild
- Werkzeuge: Research