Vertrauliche Daten lokal halten
AlleOb private Notizen oder vertrauliche Geschäftsdaten: CompanyWizard ist so gebaut, dass Sie selbst bestimmen, wo Ihre Daten liegen und ob etwas den Rechner verlässt. Dieser Artikel erklärt das Modell dahinter. Die konkrete Einrichtung beschreibt So halten Sie vertrauliche Daten vollständig lokal.
Drei Fragen entscheiden über Vertraulichkeit
Section titled “Drei Fragen entscheiden über Vertraulichkeit”- Wo liegt der Inhalt? In einem lokalen, privaten Tresor auf Ihrem Rechner – oder in einem geteilten Tresor auf einer zentralen Instanz?
- Wo liegen die Such-Vektoren? In der eingebauten sqlite-vec-Datenbank lokal – oder in einem Qdrant auf dem Server?
- Welches Modell beantwortet die Frage? Ein lokales Modell auf Ihrem Rechner – oder ein Cloud-Modell über das Internet?
Erst alle drei zusammen ergeben das Vertraulichkeitsniveau.
Was immer lokal bleibt
Section titled “Was immer lokal bleibt”- Private/lokale Tresore (Inhalt und deren Such-Vektoren) liegen auf Ihrem Rechner und werden nie an eine zentrale Instanz übertragen.
- Der Konfigurations-Abgleich zwischen Desktops (Peer-Sync) überträgt ausschließlich Einstellungen (Modellanbieter, MCP-Server, Prompts, Skill-Namen, Systemeinstellungen) – keine Tresor-Inhalte, keine Wissensdokumente, keine Vektoren. → Verbindungen / Peer-Server-Sync
- Bei einem geteilten Tresor wird live auf dem Server gesucht; die Desktop-Suche fusioniert lokale und entfernte Treffer. Ihre privaten Tresore bleiben dabei in der lokalen Suche.
Wichtige Präzisierung: Das Vektor-Backend wird global pro Installation gewählt, nicht pro Tresor. „sqlite-vec für privat, Qdrant für geteilt” auf demselben Desktop gibt es nicht. Korrekt ist: lokale Tresore werden im lokalen Backend (sqlite-vec oder BM25) durchsucht, geteilte Tresore auf dem Server.
Die Modell-Grenze (wichtig!)
Section titled “Die Modell-Grenze (wichtig!)”Der einzige Punkt, an dem Daten den Rechner verlassen können, ist der Aufruf des Sprachmodells:
- Mit einem Cloud-Modell werden Eingabe-PII vor dem Versand pseudonymisiert (PII-Schild/Presidio). → Der PII-Schild
- Auch der Wissenskontext (RAG) aus dem Tresor wird pseudonymisiert — direkt nach der Suche, bevor Reranking und Prompt ihn sehen. Im Klartext gehen dagegen:
- die Quellenangabe jedes Treffers (Dateipfad und Abschnittsüberschrift) — sonst wären Zitate wertlos;
- Dateien, die der Assistent über die Arbeitsordner-Werkzeuge liest, inklusive Git und Office-Dateien (nur Desktop) — bewusst ausgenommen, damit Code, Pfade und Dateinamen unverfälscht bleiben. → Werkzeuge: Arbeitsordner & Git
- Termine aus den Kalender-Werkzeugen. → Werkzeuge: Kalender
- Ergebnisse von Werkzeugen, die ein Admin als PII-Ausnahme markiert hat. → Konfigurierbare Werkzeuge
- alles, solange im Chat „PII-Schutz Aus” gewählt ist (standardmäßig erlaubt; Admins können den Schalter sperren). → Der PII-Schild
- Pseudonymisiert heißt nicht „nicht übertragen”: Der Inhalt geht mit Platzhaltern trotzdem an den Anbieter, und die Erkennung ist Mustererkennung — sie kann etwas übersehen und arbeitet bei einer Störung des Erkennungsdienstes nur eingeschränkt. „Verlässt den Rechner nie” gilt also nur mit einem lokalen Modell.
- Mit einem lokalen Modell (z. B. Ollama/LM Studio) bleibt auch dieser Schritt auf dem Rechner – nichts geht nach außen.
- Und ein weiterer Ausgang: Jedes externe Werkzeug, das der Assistent aufruft (MCP-Server, konfiguriertes Tool), ist ein eigener Weg nach außen. Dessen Argumente sind pseudonymisiert — es sei denn, ein Admin hat dieses Ziel als vertrauenswürdig markiert; dann erhält es die Original-Werte. Standardmäßig ist kein Ziel vertrauenswürdig.
- Und der Embedding-Provider: Beim Indexieren der Wissensbasis erhält er Dokumenttexte standardmäßig im Original — ganz ohne Häkchen, bis ein Admin Scrub before embed einschaltet. Suchanfragen aus dem Chat gehen pseudonymisiert an ihn, es sei denn, er ist als vertrauenswürdig markiert. Mit einem lokalen Embedding-Modell bleibt beides auf dem Rechner. → Vertrauenswürdige Ziele (PII-Abfluss)
Drei Vertraulichkeitsstufen
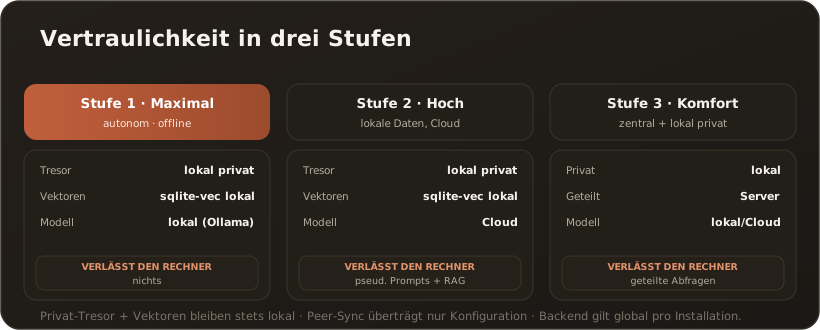
Section titled “Drei Vertraulichkeitsstufen”Stufe 1 — Maximal (vollständig offline). Autonomer Desktop ohne zentrale Anbindung + lokales Modell + sqlite-vec. Inhalt, Vektoren und Modellantworten bleiben auf dem Rechner. Nichts verlässt die Maschine. Empfehlung für höchste Vertraulichkeit.
Stufe 2 — Hoch (lokale Daten, Cloud-Modell). Autonomer oder selbst gehosteter Betrieb + privater lokaler Tresor + Cloud-Modell. Inhalt und Vektoren bleiben lokal; nach außen gehen pseudonymisierte Prompts samt pseudonymisiertem RAG-Kontext – mit den oben genannten Ausnahmen (Quellenangaben, Arbeitsordner-Dateien, Kalender, PII-Ausnahmen). Geeignet, wenn das beste Cloud-Modell nötig ist und die Tresor-Inhalte als unternehmenskontrolliert akzeptiert werden.
Stufe 3 — Komfort (zentral geteilt + lokal privat). Desktop koppelt an eine zentrale Instanz für geteiltes Wissen und führt zugleich private lokale Tresore. Privates bleibt lokal, Geteiltes liegt auf dem Server; die Suche fusioniert beides. Beste Zusammenarbeit, mit klar getrennter Privatsphäre.