RAG & Suche: sqlite-vec, Qdrant und BM25
AlleDamit die KI auf Basis Ihrer Dokumente antwortet, durchsucht CompanyWizard die Wissensbasis und reicht die passenden Stellen als Kontext an das Modell (RAG — Retrieval-Augmented Generation). Für die Suche gibt es drei Backends; welches greift, hängt von Ihrer Konfiguration ab.
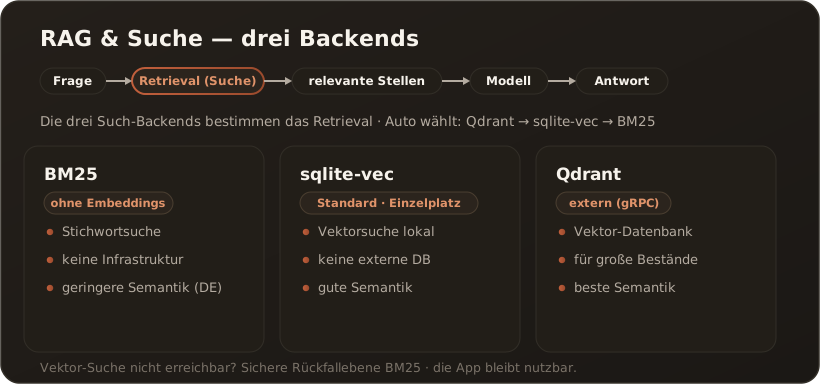
Die drei Backends
Section titled “Die drei Backends”- BM25 (Stichwortsuche) — eine klassische Schlagwortsuche ganz ohne Embeddings und ohne externe Datenbank. Sofort einsatzbereit, aber rein wörtlich: bei Synonymen und sinngemäßen Fragen (gerade auf Deutsch) ist die Trefferquote spürbar geringer.
- sqlite-vec (eingebaute Vektorsuche) — semantische Suche über eine lokale Datei, ohne externe Infrastruktur. Für den Einzelplatz die empfohlene Wahl: versteht Bedeutung, nichts zusätzlich zu betreiben. Benötigt ein Embedding-Modell.
- Qdrant (externe Vektordatenbank) — ebenfalls semantisch, aber als eigenständiger Dienst (gRPC). Lohnt sich bei großen Beständen und im Mehrplatz-/Web-Betrieb.
Wie die Auswahl funktioniert (Modus „Auto”)
Section titled “Wie die Auswahl funktioniert (Modus „Auto”)”Standardmäßig wählt CompanyWizard automatisch — in dieser Reihenfolge:
- Qdrant, wenn ein Endpoint konfiguriert und erreichbar ist;
- sonst sqlite-vec, wenn ein Embedding-Modell konfiguriert ist;
- sonst BM25 als Rückfallebene.
Sie können einen Modus auch fest wählen. Wichtig: Ist eine Vektor-Suche aktiv, aber gerade nicht erreichbar (z. B. Qdrant offline), fällt die Suche zur Laufzeit sicher auf BM25 zurück — die App bleibt nutzbar.
Hybride Suche (BM25 + Vektor)
Section titled “Hybride Suche (BM25 + Vektor)”Ist ein Vektor-Backend aktiv, läuft die BM25-Stichwortsuche nicht nur als Rückfallebene, sondern zusätzlich und immer als zweite Trefferliste mit — beide Ergebnislisten werden anschließend zu einer Reihenfolge zusammengeführt (Reciprocal Rank Fusion). Kurz: Beide Suchwege laufen immer; die Ergebnisse werden zusammengeführt. Fällt der Vektordienst aus, trägt die Stichwortsuche allein.
Das verbessert vor allem exakte Begriffs-Treffer, die eine rein semantische Suche gelegentlich übersieht: Produktnamen, Fehlercodes, Abkürzungen und deutsche Fachkomposita. Die Hybrid-Suche greift überall dort, wo die Wissensbasis durchsucht wird — im Chat (RAG), im Werkzeug search_knowledge_base und auf der Wissens-Seite.
Gesteuert wird das über den Admin-Schalter „Hybride Suche (semantisch + Stichwort)” in den Systemeinstellungen (Standard: an). Der Schalter greift sofort pro Suche — kein Neustart nötig. Deaktiviert man ihn, läuft wieder die reine Vektorsuche.
Optionale LLM-Neusortierung (Rerank)
Section titled “Optionale LLM-Neusortierung (Rerank)”Unabhängig vom Backend kann ein LLM-Reranking-Step die gefundenen Stellen vor der Antwort noch einmal neu bewerten und sortieren: Die Vorsuche holt mehr Kandidaten, ein günstiges Modell sortiert die relevantesten nach oben, nur die besten landen im Kontext. Das hilft vor allem bei schwachem Recall (BM25-Fallback, deutsche Synonym-Queries). Der Step ist optional, braucht eine Pro-/Site-Lizenz und ist ohne Konfiguration wirkungslos (dann gilt die normale RRF-Reihenfolge). → LLM-Neusortierung der Chat-Wissenstreffer
Welches Backend wofür?
Section titled “Welches Backend wofür?”- Einzelplatz, schnell startklar: sqlite-vec (semantisch) oder, ganz ohne Embeddings, BM25.
- Großer Wissensbestand / Team / Web: Qdrant.
- Nur ausprobieren / kein Embedding-Schlüssel: BM25 genügt zum Start.
Hinweis: Bei aktivem BM25 zeigt die App einen „Local index”-Hinweis. Die Trefferqualität ist geringer als bei Vektorsuche — für produktive Wissensarbeit lohnt sich sqlite-vec oder Qdrant.
Verwandt
Section titled “Verwandt”- Einzelarbeitsplatz konfigurieren — Suchmodus im Setup-Assistenten
- Ihr erstes Dokument in der Wissensbasis