Admin-Tab: Modell-Vergleich
AdminDer Modell-Vergleich lässt Endnutzer dieselbe Frage an mehrere Modelle stellen, blind für die beste abstimmen und eine Judge-Bewertung erhalten. Als Administrator steuern Sie das Feature über einen eigenen Einstellungs-Abschnitt und über die Lizenzstufe. Die Endnutzer-Bedienung ist separat beschrieben. → Modelle im Chat vergleichen
Fundort
Section titled “Fundort”Administration → Bereich KI/Prompts → Abschnitt „Modell-Vergleich”. Der Abschnitt konfiguriert das Bewertungsmodell, die Standard-Vorauswahl und das Limit pro Lauf.
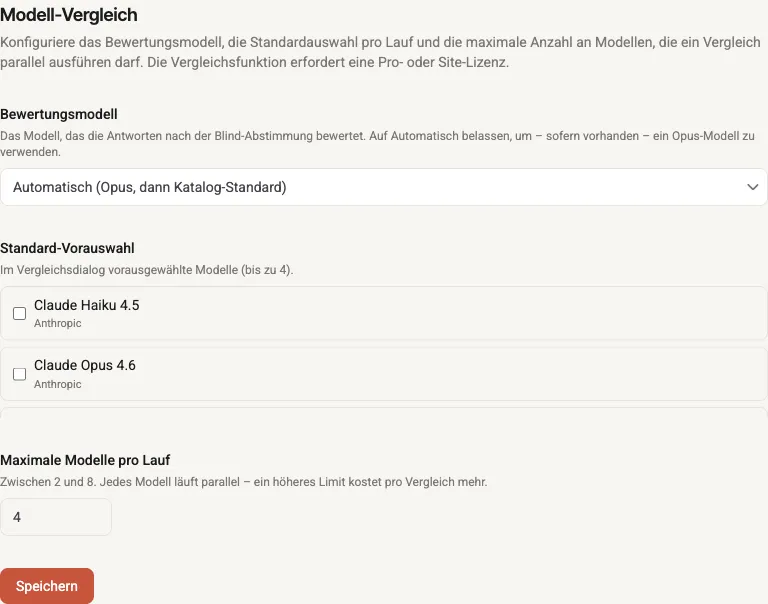
Der Admin-Abschnitt: Bewertungsmodell (Auto = Opus), Standard-Vorauswahl und Max. Modelle pro Lauf (2–8).
Bewertungsmodell (Judge)
Section titled “Bewertungsmodell (Judge)”Das Bewertungsmodell ist das Modell, das die Antworten nach der Blind-Abstimmung bewertet und je eine Empfehlung abgibt.
- Auf „Automatisch” belassen (leer): Der Standard. Der Lauf wählt selbst — „Automatisch (Opus, dann Katalog-Standard)”. Konkret: sofern ein Opus-Modell aktiviert ist, wird es als Judge genutzt; andernfalls das Katalog-Standard-Chat-Modell.
- Festes Modell wählen: Überschreibt die Automatik mit einem konkreten aktivierten Chat-Modell.
Stale-Judge-Warnung
Section titled “Stale-Judge-Warnung”Ist das gespeicherte Bewertungsmodell kein aktiviertes Chat-Modell mehr — z. B. weil sein Provider gelöscht oder deaktiviert wurde — erscheint eine Warnung: „Das zuvor gewählte Bewertungsmodell ist nicht mehr verfügbar; Vergleiche nutzen ersatzweise den automatischen Opus-Judge, bis du ein neues wählst.” Der laufende Betrieb fällt automatisch auf die Automatik zurück — Vergleiche funktionieren also weiter. Wählen Sie bei Gelegenheit ein neues Bewertungsmodell oder setzen Sie den Wert bewusst auf „Automatisch”.
Standard-Vorauswahl
Section titled “Standard-Vorauswahl”Legt fest, welche Modelle im Start-Dialog des Endnutzers vorangehakt sind (bis zur eingestellten Obergrenze). Unabhängig davon wird das aktuelle Chat-Modell des Nutzers ohnehin immer vorausgewählt — die Standard-Vorauswahl füllt die restlichen Plätze auf. Gespeicherte Modelle, die nicht mehr aufgelöst werden können, werden beim Laden still verworfen.
Maximale Modelle pro Lauf
Section titled “Maximale Modelle pro Lauf”Wie viele Modelle ein einzelner Vergleich parallel ausführen darf. Der Wert ist auf 2–8 geklammert (Standard 4). Jedes zusätzliche Modell bedeutet einen weiteren parallelen LLM-Lauf plus die Judge-Bewertung — ein höheres Limit kostet also pro Vergleich mehr. Senken Sie das Limit, wird eine zu große Standard-Vorauswahl automatisch auf das neue Maximum gekürzt.
Lizenz-Gate: Pro/Site
Section titled “Lizenz-Gate: Pro/Site”Der Modell-Vergleich ist ein Pro/Site-Feature und wird serverseitig durchgesetzt — die Einstellungen hier konfigurieren nur, das Gate greift beim Start eines Laufs.
- Free-Nutzer sehen im Chat statt eines Fehlers einen Upgrade-Hinweis im Start-Dialog.
- Abgelaufenes Pro blockiert: Ein nur-lesend abgelaufener, widerrufener oder herabgestufter Lizenzstatus zählt nicht als aktiv — der Vergleich ist dann gesperrt.
Hot-Reload — sofort wirksam
Section titled “Hot-Reload — sofort wirksam”Änderungen an diesen Einstellungen greifen sofort, ohne Neustart: Der Executor, der Judge und die Vorauswahl lesen die Werte bei jeder Nutzung neu. Speichern genügt („Einstellungen gespeichert.”).